תיקון שגיאות קוונטי: המחסום שמפריד בין הדגמה מרשימה למחשב שימושי
קיוביט טועה בשיעור שהיה מרסק כל מחשב רגיל, ולכן הענף מקבץ מאות קיוביטים פיזיים לקיוביט לוגי יציב אחד. זה ההסבר לפער בין הכרזות על אלפי קיוביטים לבין מכונה שמריצה אלגוריתם שלם, וזה גם המדד שקובע מתי הטכנולוגיה תתחיל להחזיר את ההשקעה

כשחברה מכריזה על מעבד קוונטי חדש, המספר שמככב בכותרת הוא כמעט תמיד מספר הקיוביטים. זהו גם המספר שמסביר הכי מעט. המדד שקובע אם מכונה מסוגלת לעבוד הוא שיעור השגיאה, והדרך להתמודד איתו נקראת תיקון שגיאות קוונטי.
הפער בין שני המדדים מסביר למה מכונות עם מאות קיוביטים קיימות כבר שנים, ובכל זאת החישוב המסחרי הרגיל ממשיך לרוץ על שרתים רגילים.
למה קיוביט טועה כל כך הרבה
ביט במחשב רגיל יציב להפליא. שיעור השגיאה שלו נמוך עד כדי כך שאפשר להתעלם ממנו ברוב היישומים. קיוביט מתנהג הפוך: הוא מחזיק מצב עדין שמתפרק מכל הפרעה חיצונית, ומאבד את המידע תוך מיקרו-שניות עד מילי-שניות, תלוי בשיטה.
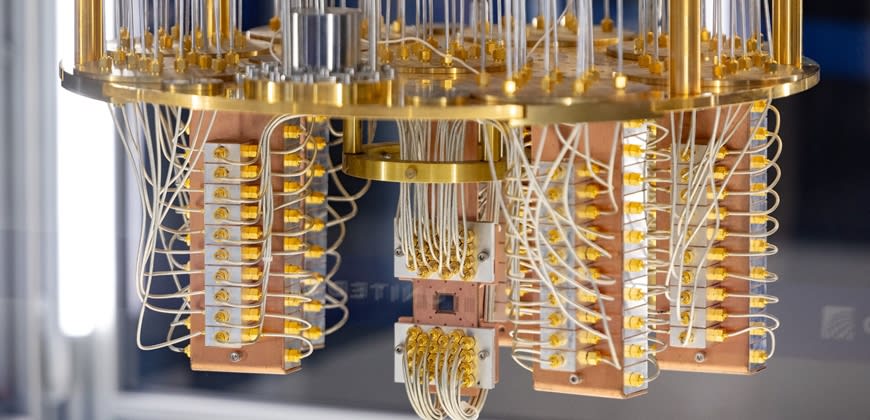
מקורות ההפרעה מגוונים: קרינה קוסמית, רעש חשמלי, רטט מכני ואפילו חום שנפלט מהחיווט עצמו. לכן המעבדים יושבים בתוך מערכות קירור מדורגות, ולכן הקירור הפך למחסום הנדסי בפני עצמו. IBM דיווחה השנה שהיא פתרה בעיית קירור שעצרה את הדרך למכונות גדולות.
מעבר לאובדן המידע, יש סוג שגיאה שני: פעולה שמופעלת על הקיוביט מבוצעת בדיוק חלקי. גם סטייה זעירה מצטברת לאורך אלפי פעולות, עד שהתוצאה הופכת לרעש.
יש כאן מלכודת שקל לפספס. בעולם הרגיל, הדרך הפשוטה להתמודד עם רעש היא לשכפל: שולחים את אותו ביט שלוש פעמים, ואם אחד מהם התהפך בדרך, הרוב מכריע. בעולם הקוונטי הטריק הזה אסור פיזיקלית. משפט ידוע בשם "משפט האי-שכפול" קובע שאי אפשר להעתיק מצב קוונטי לא ידוע, וכל ניסיון להסתכל על הקיוביט כדי לבדוק מה מצבו הורס בדיוק את המצב שרצינו לשמור.
כאן נכנס התחכום. הקוד לא מודד את הקיוביטים עצמם אלא את היחסים ביניהם. במקום לשאול "מה הערך של הקיוביט הזה", המערכת שואלת "האם שני הקיוביטים האלה מסכימים זה עם זה", וזו שאלה שאפשר לשאול בלי להרוס את המידע. מהתשובות האלה מסיקים איפה קרתה השגיאה ומתקנים אותה, בלי שאיש הביט אי פעם על התוכן.
קיוביט פיזי מול קיוביט לוגי
הפתרון שאומץ בענף הוא יתירות. במקום להסתמך על קיוביט בודד, מקבצים קבוצה שלמה של קיוביטים פיזיים ומפעילים עליהם קוד מתמטי שמזהה שגיאות ומתקן אותן תוך כדי ריצה. הקבוצה כולה מתפקדת כקיוביט אחד אמין, שנקרא קיוביט לוגי.
היחס בין השניים הוא לב העניין. לפי ההערכות המקובלות נדרשים עשרות ולעיתים מאות קיוביטים פיזיים לכל קיוביט לוגי, והיחס משתנה לפי איכות החומרה. חומרה טובה יותר מורידה את המחיר הזה, וזו הסיבה שחברות משקיעות בשיפור הדיוק במקום להתחרות במספרים בלבד.
- איון קיו רוכשת חברת סייבר בעד 1.3 מיליארד דולר - והמניה נופלת 10%
- IBM קיבלה את החותמת של הפנטגון במרוץ הקוונטי - ומתחרה בולטת נשארה בחוץ
המשמעות המעשית ברורה: מכונה עם אלף קיוביטים פיזיים עשויה להחזיק כמה קיוביטים לוגיים בודדים. אלגוריתם מסחרי רציני דורש הרבה יותר מזה.
הקוד הנפוץ ביותר נקרא קוד משטח. מסדרים את הקיוביטים על גבי רשת דו ממדית, שבה חלק מהם נושאים את המידע וחלק תפקידם רק לשאול את שאלות ההשוואה. ככל שהרשת גדולה יותר, כך המערכת עמידה יותר לשגיאות. זה גם מסביר למה מדובר בעשרות ומאות: הריבוע צריך להיות מספיק גדול כדי שהסתברות לשגיאה שתחמוק דרכו תהיה זניחה.
ויש עלות נוספת שכמעט לא מדברים עליה. חלק מהפעולות שמחשב קוונטי חייב לבצע לא מסתדרות היטב עם הקוד, ובשבילן נדרש תהליך נפרד שמייצר "מצבים מיוחדים" באיכות גבוהה ומזקק אותם. התהליך הזה בולע בעצמו כמות גדולה של קיוביטים וזמן מכונה, ובחישובים רציניים הוא עשוי לתפוס את רוב המשאבים. מי שמסתכל רק על היחס בין פיזי ללוגי מקבל תמונה אופטימית מדי.
הסף שמחליט אם התיקון עובד
לתיקון שגיאות יש תנאי כניסה. כל עוד שיעור השגיאה של הרכיבים גבוה מערך מסוים, הוספת קיוביטים לתיקון מוסיפה יותר שגיאות משהיא מתקנת, והמערכת מידרדרת. ברגע שהחומרה חוצה את הסף הזה, המצב מתהפך: כל הרחבה של הקוד מקטינה את שיעור השגיאה.
זהו הרגע שהענף מחכה לו, מפני שהוא הופך את הבעיה מבעיה מדעית לבעיה של קנה מידה והנדסה. חציית הסף היא גם הסיבה שהכרזות על שיפור דיוק מזיזות מניות יותר מהכרזות על תוספת קיוביטים.
- אפל נכנסת לסלון: מסך בית חכם ב-350 דולר ושלושה מוצרים חדשים בדרך
- מיקרוסופט מציגה שבב AI חדש: המטרה - לצמצם את התלות באנבידיה
איפה הענף עומד מול הסף
הבשורה של השנים האחרונות היא שהסף נחצה, לפחות בהדגמה. גוגל הראתה שכאשר מגדילים את רשת הקוד, שיעור השגיאה של הקיוביט הלוגי יורד במקום לעלות. זה נשמע טכני, אבל זו נקודת המפנה שהתחום חיכה לה שלושים שנה: מרגע שהמגמה הזו עובדת, השאלה כבר לא "האם אפשר" אלא "כמה זה יעלה ומתי".
ומכאן הפער עדיין עצום. הדגמה של קיוביט לוגי בודד או שניים רחוקה מאוד ממכונה שמחזיקה אלפי קיוביטים לוגיים ומריצה עליהם אלגוריתם ארוך. בין השניים עומדות בעיות שהן פחות מדעיות ויותר תעשייתיות: איך מחווטים מיליון קיוביטים, איך מקררים אותם, ואיך מריצים את מעגלי התיקון בזמן אמת במהירות שמדביקה את קצב השגיאות. שלוש הבעיות האלה נפתרות היום בחדרי הנדסה, לא במאמרים.
איך לקרוא הכרזה של חברה
שלושה נתונים מפרידים בין הודעה שיווקית להתקדמות אמיתית. הראשון הוא שיעור השגיאה בפעולה על שני קיוביטים, המדד המחמיר ביותר. השני הוא משך הזמן שהמערכת שומרת על המידע. השלישי הוא מספר הקיוביטים הלוגיים שהמכונה מחזיקה בפועל.
נתון רביעי הצטרף בשנה האחרונה: היכולת לאמת את התוצאה. IBM הדגימה מקרה שבו מחשב קוונטי פתר בעיה מורכבת וגם הוכיח שהתשובה נכונה, וזה שינוי משמעותי מול הדגמות קודמות שהיה קשה לבדוק באופן עצמאי.
איך המחשוב הרגיל פתר את אותה בעיה
הרעיון של תיקון שגיאות מוכר גם בעולם הרגיל. זיכרון בשרתים משתמש בשיטות שמזהות ומתקנות היפוך של סיביות בודדות, ותקשורת ספרתית מוסיפה מידע עודף כדי לשחזר חבילות שנפגעו בדרך. העיקרון זהה: שולחים יותר מידע ממה שנדרש, ומשתמשים בעודף לזיהוי טעויות.
ההבדל הוא בעלות. בעולם הרגיל התוספת מסתכמת באחוזים בודדים מהחומרה. בעולם הקוונטי היא מכפילה את הכמות פי עשרות, מפני שקיוביט ניתן למדידה בדרכים עקיפות בלבד. מדידה ישירה הורסת את המצב שרצינו לשמור, ולכן הקוד מודד תכונות משותפות של קבוצת קיוביטים במקום את הקיוביט עצמו.
מי קרוב יותר לסף
לשיטות השונות יש נקודות פתיחה שונות. יונים לכודים מציגים היסטורית את הדיוק הגבוה ביותר בפעולות, אבל פועלים לאט יחסית ומתקשים בהגדלת המערכת. מעגלים על-מוליכים מהירים בהרבה ומתרחבים בקלות רבה יותר, ובתמורה נאבקים על דיוק וקירור.
אטומים ניטרליים ופוטונים מציעים דרכים לעקוף חלק מהמגבלות, וכל אחת מהן עדיין מוכיחה את עצמה. התוצאה היא שהענף מנהל במקביל כמה מרוצים שונים, וקשה לקבוע מי מוביל בלי לציין באיזה מדד מדובר.
למה זה קובע את התמחור
כל תזת ההשקעה בענף נשענת על השאלה מתי יגיע מחשב עם מספיק קיוביטים לוגיים לפתור בעיה בעלת ערך כלכלי. הזזה של חמש שנים בהנחה הזו משנה לחלוטין את הערך הנוכחי של חברות שמפסידות היום עשרות ומאות מיליוני דולרים בשנה.
גם חברות שבנו את עצמן על גישות ממוקדות יותר נעות לכיוון הזה. D-Wave, שהתמחתה באנילינג קוונטי, הציבה יעד להגיע לקיוביטים לוגיים, מהלך שממחיש שהמדד הזה הפך לשפה המשותפת של הענף כולו.
עבור מי שעוקב אחרי הסקטור, ההמלצה המעשית פשוטה: לעקוב אחרי מפות הדרכים שהחברות מפרסמות, ולבדוק בכל רבעון אם היעדים נדחו. דחייה חוזרת של יעד היא האינדיקציה המוקדמת ביותר לכך שההנחות בבסיס התמחור זקוקות לעדכון.
מה זה משנה למי שמחוץ לענף
ההשלכה המיידית ביותר נוגעת להצפנה. אלגוריתם שור, שמאיים על שיטות ההגנה הנפוצות, דורש מספר גדול של קיוביטים לוגיים יציבים. כל התקדמות בתיקון שגיאות מקרבת את המועד הזה, ולכן גופים פיננסיים וממשלתיים כבר מחליפים תקני הצפנה מבעוד מועד.
ההשלכה השנייה כלכלית. חברות תרופות וחומרים בוחנות היום שיתופי פעולה עם ספקיות קוונטים, ורובן מתנות התקשרות רחבה בהגעה לרף מסוים של אמינות. הרף הזה מוגדר בקיוביטים לוגיים, ולכן ההתקדמות בתיקון השגיאות היא שקובעת מתי ייפתחו תקציבי הלקוחות הגדולים.
מה יכול להשתבש
התרחיש הרע אינו שהפיזיקה לא תעבוד. הוא שהיא תעבוד, אבל במחיר שלא משתלם. אם היחס בין קיוביטים פיזיים ללוגיים יישאר גבוה, מכונה שימושית תדרוש מפעל שלם, צריכת חשמל של מרכז נתונים והשקעה שרק מדינות יוכלו לממן. במצב כזה הטכנולוגיה תתקיים, אבל היא תישאר כלי מחקרי יקר ולא מוצר מסחרי, ורוב החברות הציבוריות בענף לא ישרדו את הדרך לשם.
תרחיש שני הוא של הפתעה מכיוון אחר. אם גישה חומרתית שנחשבת היום שנייה בתור תצליח לקצץ דרמטית את עלות התיקון, שנים של השקעה בגישה המובילה עלולות לאבד ערך בבת אחת. זה בדיוק מה שהופך את התחום למסוכן: ההתקדמות בו אינה ליניארית, וקפיצה אחת של מתחרה משנה את התמונה כולה.
ולצד שני התרחישים האלה יש גם אפשרות הפוכה, שמדברים עליה פחות. ייתכן שיימצאו אלגוריתמים שמסתדרים עם רמת רעש גבוהה יותר, וכך יורידו את הרף הנדרש מהחומרה. חלק ניכר מהמחקר היום מתנהל בדיוק בכיוון הזה, מתוך הבנה שקל יותר לשפר תוכנה מאשר לבנות מיליון קיוביטים.
- 2.אנונימי 30/08/2026 12:01הגב לתגובה זותעירו אותי כשיהיה פתרון
- 1.infq הסוס המנצח (ל"ת)אנונימי 29/08/2026 21:49הגב לתגובה זו
